Tóm tắt
- Không ai đảm bảo bảo mật dữ liệu 100% khi bạn dùng ứng dụng AI của người khác. Bạn dựa vào niềm tin có cơ sở.
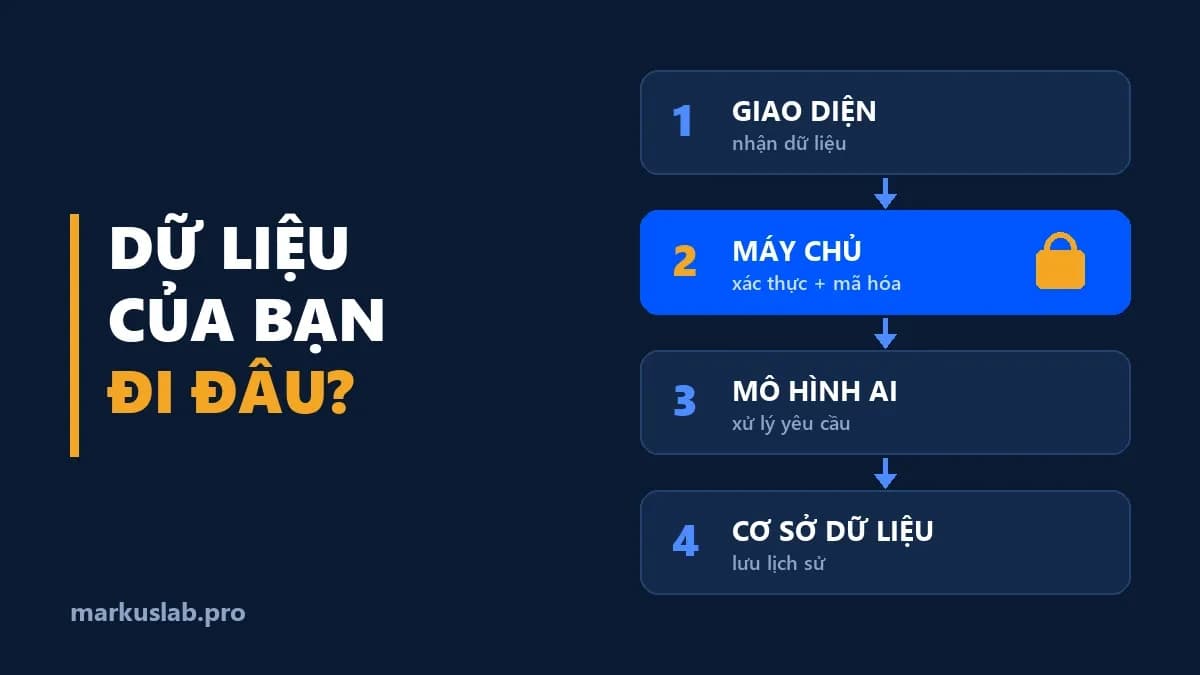
- Dữ liệu đi qua 4 tầng: giao diện, máy chủ, mô hình AI, cơ sở dữ liệu.
- Xác thực chặn người lạ. Mã hóa khiến nhà phát triển chỉ thấy khách hàng XYZ.
- Chứng nhận SOC 2, ISO 27001 và GDPR là thứ nên đòi xem.
- Muốn kiểm soát hoàn toàn thì phải sở hữu cả chu trình.
Bảo mật dữ liệu khi dùng AI là câu tôi được hỏi nhiều nhất trong các buổi làm việc với chủ doanh nghiệp: "Tôi xài ChatGPT thì nó có lấy dữ liệu của tôi không?". Câu hỏi đó rất đúng. Nhưng nó thường được hỏi khi người hỏi chưa nhìn thấy dữ liệu của mình đi đâu, nên câu trả lời nào nghe cũng giống một lời trấn an.
Trả lời thẳng: không ai đảm bảo được bảo mật dữ liệu 100% khi bạn dùng một ứng dụng AI của người khác. Thứ bạn đang dựa vào là niềm tin vào nhà cung cấp. Niềm tin đó có cơ sở khi nhà cung cấp mã hóa dữ liệu, xác thực đúng người, công khai chính sách lưu trữ và có chứng nhận độc lập. Muốn kiểm soát hoàn toàn thì bạn phải sở hữu cả chu trình.
Bài này vẽ lại đường đi của dữ liệu qua bốn tầng của một ứng dụng, để bạn tự trả lời câu hỏi đó mà không cần nền tảng kỹ thuật.
ChatGPT hay Claude có khác gì một ứng dụng bình thường?
Điều đầu tiên cần gỡ: ChatGPT, Claude hay bất kỳ công cụ AI nào bạn đang dùng đều là phần mềm. Khác biệt duy nhất là bên trong có một mô hình AI làm phần việc chuyên môn. Nhìn về cấu trúc, nó vẫn là một ứng dụng.
Hiểu như vậy thì câu hỏi "AI có an toàn không" đổi thành một câu dễ trả lời hơn: dữ liệu của tôi đi qua những chỗ nào, và ở mỗi chỗ ai nhìn thấy được nó?
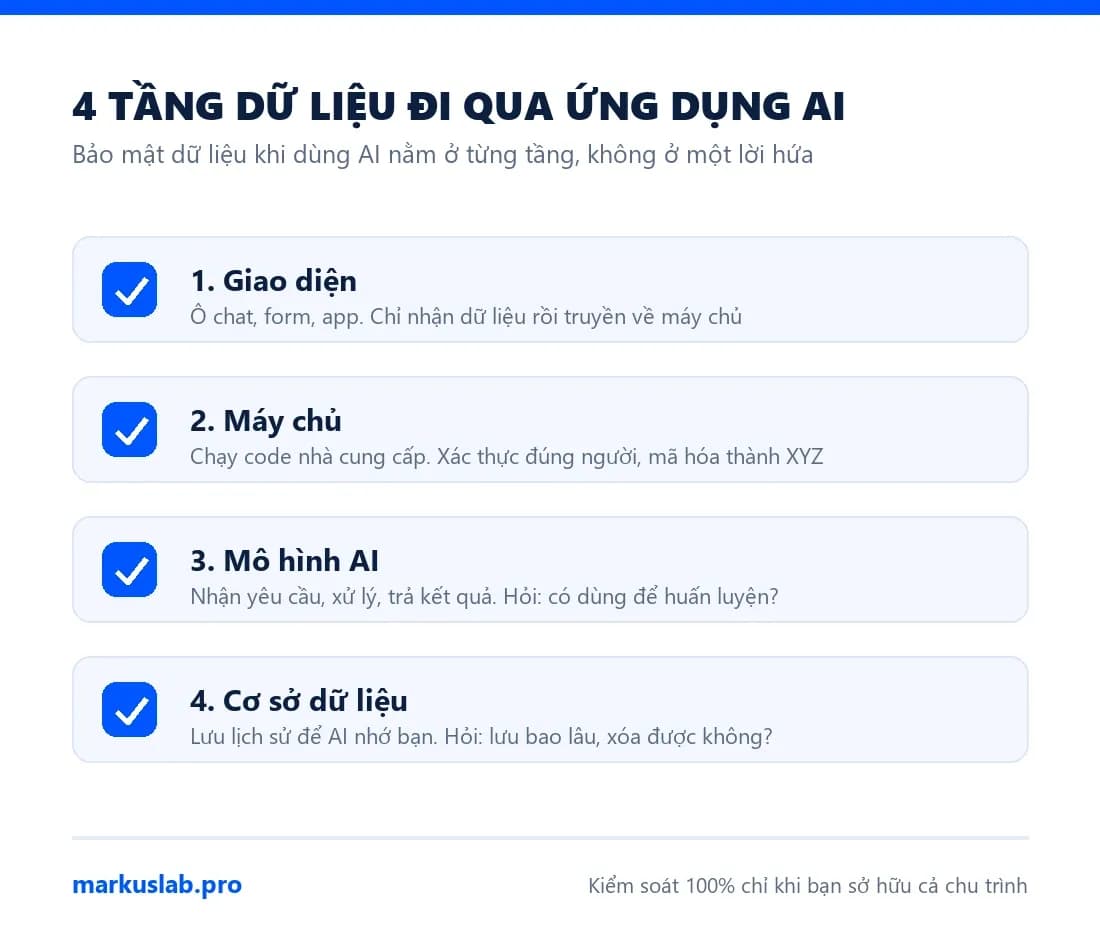
4 tầng dữ liệu đi qua khi bạn chat với AI
Mỗi lần bạn gõ một yêu cầu, dữ liệu đi qua bốn tầng rồi mới quay về màn hình của bạn.
| Tầng | Vai trò | Câu nên hỏi nhà cung cấp |
|---|---|---|
| 1. Giao diện | Ô chat, form, app trên điện thoại. Chỉ nhận dữ liệu, không xử lý | Dữ liệu có được mã hóa khi truyền đi không? |
| 2. Máy chủ | Chạy code, logic của nhà cung cấp | Ai trong công ty họ truy cập được máy chủ? |
| 3. Mô hình AI | Nhận yêu cầu, xử lý, trả kết quả | Dữ liệu của tôi có được dùng để huấn luyện mô hình không? |
| 4. Cơ sở dữ liệu | Lưu lịch sử để AI nhớ được bạn | Lưu bao lâu, xóa được không? |
Tầng 1: giao diện chỉ là cái form
Giao diện là nơi bạn gõ hoặc nói yêu cầu vào. Hãy hình dung nó như một cái form: nó nhận dữ liệu, không xử lý gì cả. Nhận xong, nó truyền dữ liệu qua mạng về máy chủ của nhà cung cấp.
Tầng 2: máy chủ là nơi dữ liệu thật sự nằm
Về nguyên tắc, bạn nhập gì thì máy chủ có cái đó. Đây là chỗ hai lớp bảo vệ quan trọng nhất phải xuất hiện: xác thực và mã hóa.
Xác thực trả lời câu hỏi người dùng là ai. Dữ liệu của tài khoản A chỉ tài khoản A mở được. Người dùng B đăng nhập vào cùng ứng dụng, cùng máy chủ, nhưng không tìm thấy dữ liệu của A.
Mã hóa ngăn chính nhà phát triển biết dữ liệu đó thuộc về ai. Thay vì ghi rõ họ tên, năm sinh, máy chủ chỉ thấy một khách hàng XYZ đang nhập thông tin ABCD. Kỹ sư có quyền vào máy chủ cũng chỉ thấy XYZ. Đây là lớp ẩn danh.
Nhà cung cấp lớn công bố khá cụ thể phần này. OpenAI nói họ mã hóa dữ liệu lưu trữ bằng AES-256 và dữ liệu truyền đi bằng TLS 1.2 trở lên cho các gói doanh nghiệp và API (OpenAI Business data).
Tầng 3: mô hình AI phải nhận được dữ liệu mới làm việc được
Mô hình AI không làm việc trên không khí. Bạn hỏi "hôm nay trời nắng hay mưa", câu đó đi từ ô chat vào máy chủ, máy chủ chuyển xuống mô hình AI, mô hình xử lý trên hạ tầng của nó rồi trả kết quả ngược lên. Dữ liệu buộc phải được truyền tải qua cả chuỗi này.
Vì vậy xác thực và mã hóa phải có mặt ở cả chặng này nữa, không chỉ ở máy chủ. Câu hỏi đáng hỏi nhất ở tầng này là dữ liệu của bạn có bị dùng để huấn luyện mô hình không. Câu trả lời khác nhau theo từng gói. OpenAI cho biết họ không huấn luyện trên dữ liệu của ChatGPT Business, Enterprise và API trừ khi khách hàng chủ động đồng ý. Với các gói cá nhân của Claude, Anthropic chỉ dùng hội thoại để cải thiện mô hình khi người dùng cho phép, và chat ẩn danh không bị dùng dù bạn đã bật tùy chọn đó (Anthropic Privacy Center).
Tầng 4: cơ sở dữ liệu là lý do AI nhớ bạn
ChatGPT nhớ được những gì bạn nói tuần trước vì có một tầng lưu trữ. Sau khi xử lý xong, dữ liệu được ghi vào cơ sở dữ liệu. Lưu bao lâu, tự xóa sau bao lâu, là chính sách riêng của từng sản phẩm.
Câu hỏi "hôm nay trời mưa hay nắng" của bạn nằm trong đó. Nếu mã hóa làm đúng, nó gắn với một người dùng XYZ bất kỳ, không gắn với tên bạn.
Bảo mật dữ liệu khi dùng AI có đảm bảo được không?
Nói một câu thành thật: chưa chắc. Là người dùng, bạn không kiểm soát được máy chủ, mô hình hay cơ sở dữ liệu của nhà cung cấp. Bạn chỉ có niềm tin.
Niềm tin đó không phải niềm tin mù. Khi một nhà cung cấp đạt chứng nhận quốc tế, nghĩa là đã có chuyên gia độc lập đi vào xem cơ chế máy chủ, mô hình và cơ sở dữ liệu vận hành ra sao rồi mới ký xác nhận. OpenAI công bố đã qua đánh giá SOC 2 Type 2 và giữ chứng nhận ISO/IEC 27001 cho các dịch vụ doanh nghiệp. Đó là thứ bạn nên đòi xem, không phải một lời hứa trên trang quảng cáo.
Nhà cung cấp quy mô toàn cầu cần các chứng nhận này vì một lý do rất thực tế: không có thì không bán được hàng. Muốn vào châu Âu, họ phải đáp ứng GDPR. Mức phạt tối đa theo Điều 83 là 20 triệu euro hoặc 4% tổng doanh thu toàn cầu năm trước, lấy số cao hơn (GDPR Art. 83). Con số đó đủ lớn để bảo mật trở thành chuyện sống còn của họ, không phải chuyện thiện chí.
Ở Việt Nam, Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 có hiệu lực từ 01/01/2026, trao cho người dân quyền được biết, đồng ý, truy cập, chỉnh sửa và yêu cầu xóa dữ liệu (Cổng Thông tin điện tử Chính phủ). Nghĩa là trách nhiệm không chỉ nằm ở nhà cung cấp AI. Doanh nghiệp bạn đưa dữ liệu khách hàng vào công cụ nào cũng là một quyết định có hệ quả pháp lý.
Làm sao để kiểm soát dữ liệu hoàn toàn?
Có chủ doanh nghiệp nói với tôi: dữ liệu của tôi rất quý, tôi muốn kiểm soát hoàn toàn. Làm được. Điều kiện là bạn sở hữu luôn toàn bộ chu trình: ứng dụng, máy chủ, cơ sở dữ liệu, và bạn là người duy nhất truy cập.
Khi bạn vừa là người dùng vừa là người giữ máy chủ, câu chuyện xác thực và mã hóa với bên thứ ba không còn đặt ra. Dữ liệu là của bạn, nằm trên hạ tầng của bạn. Chỉ lúc đó bạn mới nói được dữ liệu của mình được bảo mật 100%.
Cái giá đi kèm cũng thật. Bạn gánh việc vận hành, cập nhật, sao lưu và chịu trách nhiệm khi có sự cố. Với phần lớn doanh nghiệp nhỏ, lựa chọn hợp lý hơn là phân loại dữ liệu: loại nào đưa lên công cụ có chứng nhận được, loại nào giữ trong hệ thống tự sở hữu. Tôi viết kỹ hơn về cách tổ chức phần dữ liệu tự sở hữu trong bài kho dữ liệu cho doanh nghiệp và xây dựng bộ não số.
Bắt đầu từ đâu trong tuần này
Đừng bắt đầu bằng việc cấm nhân viên dùng AI. Bắt đầu bằng một bảng phân loại.
- Liệt kê năm loại dữ liệu công ty bạn hay đưa vào AI nhất: báo cáo nội bộ, dữ liệu khách hàng, hợp đồng, số liệu tài chính, tài liệu đào tạo.
- Với từng loại, hỏi nhà cung cấp đúng bốn câu ở bảng trên và đọc chính sách của gói bạn đang trả tiền, không phải gói miễn phí.
- Chia làm ba nhóm: đưa lên được, đưa lên sau khi ẩn danh, giữ trong hệ thống tự sở hữu.
Phân loại xong, bảo mật dữ liệu khi dùng AI không còn là nỗi lo chung chung. Nó thành một quyết định có tiêu chí, người trong công ty làm theo được.
Nếu bạn đang cân nhắc đưa AI vào quy trình và cần xác định dữ liệu nào nên đi đâu, lộ trình ứng dụng AI cho doanh nghiệp là điểm bắt đầu. Bạn có thể tự làm lộ trình đó tại AI Roadmap.
Câu hỏi thường gặp
Dùng ChatGPT có bị lấy dữ liệu doanh nghiệp không?
Tùy gói bạn dùng. OpenAI cho biết họ không huấn luyện mô hình trên dữ liệu của ChatGPT Business, Enterprise và API trừ khi khách hàng chủ động đồng ý, và dữ liệu được mã hóa AES-256 khi lưu, TLS 1.2 trở lên khi truyền. Vì vậy bảo mật dữ liệu khi dùng AI bắt đầu từ việc đọc đúng chính sách của gói bạn đang trả tiền.
Xác thực và mã hóa dữ liệu khác nhau thế nào?
Xác thực trả lời câu hỏi người dùng là ai, để dữ liệu của tài khoản A chỉ tài khoản A mở được. Mã hóa ngăn chính nhà phát triển biết dữ liệu thuộc về ai: trên máy chủ họ chỉ thấy một khách hàng XYZ thay vì họ tên của bạn. Một ứng dụng AI đáng tin cần cả hai lớp.
Làm sao để kiểm soát dữ liệu 100% khi dùng AI?
Bạn phải sở hữu cả chu trình: ứng dụng, máy chủ, cơ sở dữ liệu, và là người duy nhất truy cập. Cái giá là tự gánh vận hành, sao lưu và sự cố. Phần lớn doanh nghiệp nhỏ nên phân loại dữ liệu: loại đưa lên công cụ có chứng nhận, loại giữ trong hệ thống tự sở hữu.
Doanh nghiệp Việt Nam có nghĩa vụ gì về dữ liệu khách hàng khi dùng AI?
Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 có hiệu lực từ 01/01/2026, trao cho người dân quyền được biết, đồng ý, truy cập, chỉnh sửa và yêu cầu xóa dữ liệu. Đưa dữ liệu khách hàng vào công cụ AI nào là quyết định có hệ quả pháp lý, không chỉ là trách nhiệm của nhà cung cấp.
Nguồn tham khảo
- Business data privacy, security, and compliance, OpenAI
- Is my data used for model training?, Anthropic Privacy Center
- Art. 83 GDPR: General conditions for imposing administrative fines, gdpr-info.eu
- Luật số 91/2025/QH15 của Quốc hội: Luật Bảo vệ dữ liệu cá nhân, Cổng Thông tin điện tử Chính phủ
Nhận bài viết mới nhất từ Markus Lab
2-3 bài mỗi tuần về AI, build sản phẩm, và growth cho founder & SME Việt. Không spam, unsubscribe bất cứ lúc nào.